Powered By Blogger

viernes, 14 de junio de 2013

Estadística inferencial: muestreo y estimación

Nada más empezar esta entrada debemos dejar claro que al conjunto de procedimientos que permiten elegir muestras de tal forma que éstas reflejen las características de la población llamamos técnica de muestreo y que siempre que trabajamos con muestras debemos asumir un cierto error.
Hablando de errores, definiremos que es un error estándar: es la medida que trata de captar la variabilidad de los valores del estimador, mide el grado de variabilidad en los valores del estimador en las distintas muestras de un determinado tamaño que pudiésemos tomar de una población. Cuanto más pequeño es el error estándar de un estimador, más nos podemos fiar del valor de una muestra concreta.
Intervalos de confianza: Son un medio de conocer el parámetro en una población midiendo el error que tiene que ver con el azar (error aleatorio), se trata de un par de números tales que, con un nivel de confianza determinados, podamos asegurar que el valor del parámetro es mayor o menos que ambos números. Se puede calcular intervalos de confianza para cualquier parámetro.
Tipos de muestreo:
Muestreo probabilístico (Aleatorio): Es el método que cosiste en extraer una parte (o muestra) de forma que todas las muestras posibles del tamaño fijo, tengan la misma posibilidad de ser seleccionadas, dentro de este existen diferentes tipos:
  • Aleatorio simple: Se caracteriza porque cada unidad tiene la probabilidad equitativa de ser incluida en la muestra.
  • Sistemático: Similar al aleatorio simple, en donde cada unidad del universo tiene la misma probabilidad de ser seleccionada.
  • Estratificado: Se caracteriza por la subdivisión de la población en subgrupos o estratos, debido a que las variables principales que deben someterse a estudio presentan cierta variabilidad o distribución conocida que puede afectar a los resultados.
  • Conglomerado: Se usa cuando no se dispone de una lista detallada y enumerada de cada una de las unidades que conforman el universo y resulta más complejo elaborarla. En la selección de la muestra en lugar de escoger cada unidad se toman los subgrupos o conjuntos de unidad “conglomerados”.
Muestreo no probabilístico: No puede considerarse que la muestra sea representativa de una población, se caracteriza porque el investigador selecciona la muestra siguiendo algunos criterios identificados para los fines del estudio que realiza. Hay diferentes tipos:

  • Por conveniencia o Intencional: En el que el investigador decide, según sus objetivos, los elementos que integrarán la muestra, considerando las unidades “típicas” de la población que desea conocer.
  • Por cuotas: En el que el investigador selecciona la muestra considerando algunos fenómenos o variables a estudiar, como: Sexo, raza, religión, etc.
  • Accidental: Consiste en utilizar para el estudio las personas disponibles en un momento dado, según lo que interesa estudiar. De las tres es la más deficiente.

jueves, 13 de junio de 2013

Segundo seminario

En el segundo seminario lo que hicimos fue analizar los datos que introducimos en el primer seminario.

Para ello, nuestro profesor nos enseñó algunas herramientas que posee Epi Info para agrupar categorías, así como ver los datos del estudio. En este caso el estudio trataba de una población que había asistido a una fiesta y que un gran número de ellos cogieron gastroenteritis, entonces con los datos ya introducidos de qué habían ingerido cada una de estas personas así como otros datos relevantes, pudimos observar qué habían comido estas personas, qué número de ellas se habían puesto malas y pudimos sacar nuestras propias conjeturas, incluso representarlo gráficamente mediante el uso de gráficos.


Medidas de tendencia central, posición y dispersión.

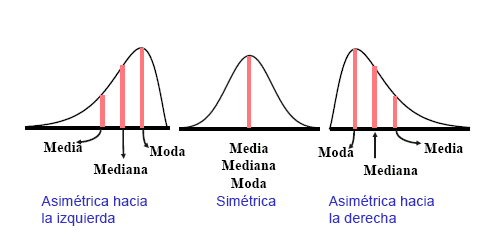
Esta entrada va dirigida a las medidas de tendencia central, posición y dispersión, por lo que al ser conceptos clave no puedo explicarlo exactamente con mis palabras por lo que he aclarado los conceptos y colocado gráficas para que se vean más claras estas medidas.

Empezamos definiendo qué es un parámetro o estadístico: es un número que resume la información recogida en una población o una muestra y existen tres tipos de estadísticos:
  1. Medidas de tendencia central
  2. Medidas de posición
  3. Medidas de dispersión
Medidas de tendencia central
  • Media aritmética o media: es la suma de todos los valores de la variable observada entre el total de observación.
  • Media ponderada: es la media de diferentes valores.
  • Mediana: es el valor de la observación tal que un 50% de los datos es menor y otro 50% es mayor.
  • Moda: es el valor que más veces se repite.
Medidas de posición
  • Cuantiles o n-tiles: sólo tienen en cuenta la posición de los valores en la muestra.
  • Percentiles: dividen la muestra ordenada en 100 partes.
  • Deciles: dividen la muestra ordenada en 10 partes.
  • Cuartiles: dividen la muestra ordenada en 4 partes.
Medidas de dispersión
  • Rango o recorrido: diferencia entre el mayor y el menos valor de la muestra.
  • Desviación media: media aritmética de las distancias de cada observación con respecto a la media de la muestra.
  • Desviación típica: cuantifica el error que cometemos si representamos una muestra únicamente pos su medida.
  • Varianza: expresa la misma información en valores cuadráticos.
  • Recorrido intercuartílico: diferencia entre el tercer y el primer cuartil.
  • Coeficiente de variación: nos sirve para comparar la heterogeneidad de dos series numéricas con independencia de las unidades de medidas.
Distribuciones normales:
  • En estadística se llama distribución normal, distribución de Gauss, a una de las distribuciones de probabilidad de variable continua que con más frecuencia aparece en fenómenos reales.
  • Esta curva se conoce como campana de Gauss. (ejemplo gráfico)

Asimetría y curtosis:

Coeficiente de asimetría de una variable: Grado de asimetría de la distribución de sus datos en torno a su media.
·         g1=0 (distribución simétrica)
·         g1>0 (distribución asimétrica positiva, existe mayor concentración de valores a la derecha que a la izquierda)
·         g1<0 (distribución asimétrica negativa, existe mayor concentración de valores a la izquierda que a la derecha)
Curtosis o apuntamiento:
  • Es una variable sirve para medir el grado de concentración de los valores que toma en torno a su media
  • Los resultados pueden ser los siguientes:
×          g2=0 (distribución mesocúrtica, es una distribución normal)
×          g2>0 (distribución leptocúrtica, larga (hacia arriba))
×          g2<0 (distribución platicúrtica, más llana (hacia abajo))

Introducción a la bioestadística. Organización de los datos.

En este tema conoceremos conceptos claves a la hora de desarrollar nuestros métodos y el material necesario para nuestro estudio.

Para empezar hablaremos de la población de estudio que no es más que la selección de las personas que vamos a incluir y excluir de nuestro estudio conservando así la validez interna y externa de este, evitando los sesgos de selección que hayamos tomado en cuenta anteriormente. También hablaremos del muestreo, el muestreo no es más que el número de individuos que necesitamos para el estudio ya que es imposible incorporar a toda la población.  Existen diferentes tipos de muestreo: el muestreo aleatorio simple, el sistemático, el equi-probabilístico, el estratificado, el multi-etápico, el monstro consecutivo y por último los voluntarios.

La recogida de datos se puede hacer: de forma directa, por fuentes documentales, a través de encuestas, entrevistas, etc. En esta fase tenemos que tener en cuenta los sesgos de clasificación y, si es posible, hacer un pilotaje previo, es decir, hacer una prueba con pocas personas antes de hacer el estudio.

A la hora del análisis, mediante el programa “Epi Info” podemos analizar los datos mediante el uso de: tablas de frecuencia (tablas que muestran las frecuencias y las categorías de las variables, las frecuencias son el número de veces que una categoría aparece en nuestra población de estudio), frecuencia absoluta (número de veces que se repite cada categoría de la variable de estudio), frecuencia relativa (frecuencia absoluta dividida por el número total de casos, la suma de estas debe ser 1), frecuencia acumulada (suma de las frecuencias correspondientes a cada valor) y representación de datos mediante gráficas (exponen los datos obtenidos en nuestro estudio de forma gráfica, nos ayuda a aclarar los datos)

Primer Seminario

En el primer seminario de “Estadistica y TIC” descubrimos un nuevo programa informático llamado Epi Info, aprendimos cómo instalarlo y profundizamos levemente en su manejo. Este programa sirve para recoger la información obtenida en nuestro estudio a través de nuestros cuestionarios o entrevistas y nos ayuda a estudiar las variables de este y a analizar los diferentes datos que hemos obtenidos mediante cálculos y representaciones gráficas para que podamos llegar a nuestras conclusiones.

Para descargar Epi Enfo solo tenemos que poner en google: “cdc Epi Info” y pinchar en el primer enlace que aparece y cliqueamos en “downloads” y luego en “previus versions” y ya estaría descargado. ¡OJO! El programa está en inglés por lo que debemos usar un parche de español, que lo podemos encontrar en nuestro campus. Para ello buscamos la carpeta del ordenador donde se encuentra Epi Info y abrimos la carpeta “TransExE” y pegamos el parche en esta carpeta, después abrimos Epi Info y cambiamos el idioma al español, ya que nos debería salir como opción.

Ya solo queda aprender a manejarlo, el programa no es muy complicado. ¡Suerte!

También en este seminario comenzamos la introducción de la información referente a un estudio que vamos a analizar en los próximos seminarios.

sábado, 8 de junio de 2013

La etapa empírica de la investigación: el diseño.

Para llevar a cabo el diseño de nuestro estudio debemos tener en cuenta cuatro criterios: la finalidad de este, su secuencia temporal, si se controlan los factores de estudio y la cronología de este.
En función de la finalidad nuestro estudio puede ser analítico o descriptivo: es analítico cuando existe relación entre dos variables y descriptivo cuando se describe sin buscar relación entre las dos variables. Según la secuencia temporal puede ser transversal, porque se da en un momento del tiempo o longitudinal, que significa que el estudio necesita un lapsus de tiempo para que se lleve a cabo. Según el control de la asignación de los factores de estudio puede ser experimental u observacional y en función de la cronología puede ser: prospectivo, que significa que primero intervenimos y luego obtenemos los resultados o retrospectivo que se da cuando ya tenemos los resultados y queremos intervenir.

Por lo que, una vez sabido esto, a la hora de clasificar los estudios analíticos primero debemos saber si existe control del factor de estudio, si es que no se trata de un estudio observacional en el cual la formación de los grupos de estudio se realiza en función de la enfermedad y serían o estudios de cohortes o estudios de casos y controles. Si, por el contrario, si se controla el factor de estudio se trata de un estudio experimental, en el cual si existe un grupo de control se trata de un ensayo controlado y si no se trata de un ensayo no controlado. Dentro de los ensayos controlados si la asignación de estos grupos es aleatoria estamos hablando de un ensayo clínico aleatorio, si por el contrario la asignación de estos grupos no es aleatoria ya hablaríamos de un ensayo clínico no aleatorio.

El marco teórico y los objetivos de la investigación. Hipótesis de investigación.

A la hora de desarrollar el marco teórico debemos definir los objetivos de nuestro estudio y qué queremos lograr llevando a cabo este, por lo que debemos profundizar en la información, para ello debemos desarrollar las hipótesis del estudio. Las hipótesis son solo las relaciones existentes entre las variables (tanto dependientes como independientes), es por lo tanto, una predicción del resultado del trabajo. 

El desarrollo del marco teórico requieres de cuatro pasos:
1. Formular la pregunta correspondiente a nuestro estudio que queramos tratar. Con formular la pregunta nos referimos a reducir a términos sencillos y precisos los objetivos del estudio. Las preguntas se deben descomponer en cuatro elementos: Las llamadas Preguntas PICO:
  1. Paciente o problema de interés
  2. Intervención que se va a considerar
  3. Intervención con la que Comparar
  4. Resultado (Outcome) que se valora
2. Apoyarse en pruebas disponibles en literatura.
3. Evaluar críticamente la literatura obtenida: con esto nos referimos a determinar el nivel de evidencia que tendrá nuestro estudio en función a la metodología de cada experiencia, es decir determinar la fiabilidad del estudio. Los niveles de evidencia son:
Nivel de evidencia I: Obtenida de por lo menos un experimento clínico controlado, adecuadamente aleatorizado, o de una metaanálisis de alta calidad.
Nivel de evidencia II: Obtenida de por lo menos un experimento clínico controlado, adecuadamente aleatorizado o de un metaanálisis de alta calidad, pero con probabilidad alta de resultados falsos positivos o falsos negativos.
Nivel de evidencia III:
  • Nivel de evidencia III.1: Obtenida de experimentos controlados y no aleatorizados, pero bien diseñados en todos los demás aspectos.
  • Nivel de evidencia III.2: Obtenida de estudios analíticos observacionales bien diseñados, preferiblemente multicéntricos o con más de un grupo de investigación.
  • Nivel de evidencia III.3: Obtenida de cohortes históricas (retrospectivas), múltiples series de tiempo, o series de casos tratados.
  • Nivel de evidencia IV: Obtenida de opiniones de autoridades respetadas, basadas en la experiencia clínica no cuantificada, o en informes de comités de expertos.
4. Aplicación de las conclusiones obtenidas en nuestro estudio práctico: de los anteriores niveles de evidencia explicados se obtienen cinco grados de recomendación, los cuales son aplicables como criteros de calidad: 

  • GRADO DE RECOMENDACIÓN A: Existe evidencia satisfactoria (por lo general de Nivel I) que sustenta la recomendación para la intervención o actividad bajo consideración.
  • GRADO DE RECOMENDACIÓN B: Existe evidencia razonable (por lo general de nivel II, III.1 O III.2) que sustenta la recomendación para la intervención o actividad bajo consideración.
  • GRADO DE RECOMENDACIÓN C: Existe pobre o poca evidencia por lo general de nivel III O IV) que sustenta la recomendación para la intervención o actividad bajo consideración.
  • GRADO DE RECONMENDACIÓN D: Existe evidencia razonable (por lo general de Nivel II, II2.1 O III.2) que sustenta excluir o no llevar a cabo la intervención o actividad en consideración
  • GRADO DE RECOMENDACIÓN E: Existe evidencia satisfactoria (por lo general de Nivel I) que sustenta excluir  o no llevar a cabo la intervención o actividad en consideración.